近日,U8国际集团官网U8国际集团智能运维实验室的两篇研究论文成功被计算机体系结构领域的CCF A类国际顶级会议—— ACM SIGOPS Annual Technical Conference(ATC) 2026录用。该会议将于2026年11月15日至18日在中国香港(Hong Kong,China)举行。以下是两篇论文的简介:
论文标题:TraJudger: Structure-Guided Failure Attribution for LLM-Powered Multi-Agent Systems
论文链接:https://nkcs.iops.ai/wp-content/uploads/2026/09/atc26-paper471.pdf
作者:赵咏欣,张圣林,辜文蔚*,阙子菁,钱玮雯,孙永谦,施立,李伟,张瓅玶,裴丹
作者单位:U8国际集团官网、阿里巴巴集团、清华大学
Part.1摘要
LLM驱动的多智能体系统正被大规模部署于生产环境,但其故障诊断仍面临严峻挑战。与云架构故障可通过结构化遥测呈现不同,多智能体系统的故障往往隐藏于非结构化的自然语言交互中,跨语义边界悄然传播,且缺乏先验领域知识支撑归因。现有“LLM-as-a-Judge”方法将执行轨迹作为整体处理,容易误判级联故障的根因,并编造看似合理却缺乏依据的解释。
为此,本研究提出TraJudger——一种面向LLM多智能体系统的结构引导故障归因框架。TraJudger从原始执行轨迹构建分层认知图(Hierarchical Cognitive Graph, HCG),以还原显式的跨步骤依赖关系;部署四类面向不同故障类型的专项智能体进行分类检测;并通过图约束的反向追溯,将根因定位严格锚定在经验证的依赖路径上。在121条生产故障轨迹与126条基准故障轨迹上的实验表明,TraJudger在智能体级与步骤级归因准确率上较现有最优方法分别提升至少15%和13.3%。该系统在实际部署期间,将平均故障归因时间由30分钟缩短至1分钟以内。
Part.2背景与挑战
随着LLM多智能体系统在软件开发、数据分析、信息检索等场景中承担越来越复杂的生产任务,可靠性已成为首要关切:相当比例的执行会产生错误或违反约束的结果,给值班工程师(On-Call Engineer, OCE)带来持续的排障压力。在实际生产环境中,故障归因长期依赖人工完成——工程师需要逐一检查动辄数万个词元(token)的执行轨迹,即便经验丰富,平均单次诊断也需约30分钟,难以支撑规模化生产需求。
传统自动化诊断方法(面向云服务、微服务、数据中心网络等)依赖两大前提:结构化可观测性(如指标、分布式调用链、拓扑依赖图)与明确刻画的故障分类体系。而LLM多智能体系统两者皆不具备——智能体间交互以自然语言展开,故障隐藏于轨迹的语义内容之中,传统遥测手段难以奏效。
基于对该平台121条生产故障轨迹的实证分析,研究团队发现主流“LLM-as-a-Judge”范式存在三大系统性缺陷:其一,隐藏的跨智能体错误级联——上游细微错误通过自然语言语境悄然传播,当轨迹超过10步时,现有方法的智能体级归因准确率由0.67骤降至0.39;其二,故障类型异构导致的类别混淆——单一大语言模型评判器难以针对幻觉、逻辑不一致、执行循环、协作失败等异构故障类型分别施策,53.3%的约束违反类案例被误判为幻觉;其三,缺乏结构支撑的虚构归因——仅42.1%的前沿模型解释真正基于轨迹证据,其余均为编造的看似合理但无依据的叙述。此外,生产环境还对方法提出了非侵入式诊断(不可重新执行系统)与无需任务特定训练(标注数据有限、系统持续演进)等约束,进一步限定了可行方案的设计空间。
Part.3 核心方法与系统架构
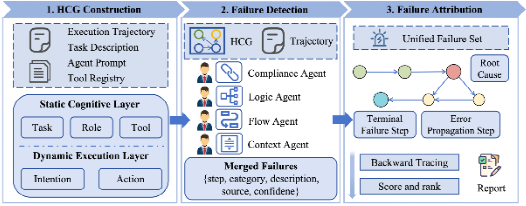
TraJudger采用三阶段架构,逐步将非结构化自然语言轨迹转化为结构化诊断结果:
阶段一:分层认知图构建。系统解析任务描述、智能体系统提示词、工具注册表与执行轨迹,构建包含静态认知层(任务节点、角色节点、工具节点)与动态执行层(意图节点、动作节点)的两层语义图。层内边刻画时序与逻辑依赖,跨层边则将每个动态步骤锚定到其应遵循的静态前提,为后续阶段提供统一的结构化证据基础。
阶段二:多专家故障检测。系统部署合规性、逻辑性、流程性与协作情境四类专项智能体,各自基于HCG中不同的节点与边类型并行开展检测:合规性专家检查任务约束与角色越权;逻辑性专家关注意图—动作一致性、推理连贯性与事实幻觉;流程性专家识别循环冗余、过早终止与工具调用错误;协作情境专家沿依赖边追踪信息流转,检查关键信息传递与遗忘问题。各专家输出的故障发现经统一格式合并去重,形成统一故障集合。
阶段三:考虑错误传递步骤的故障归因。系统在HCG基础上推断更长程的语义依赖,构建轨迹依赖图,并引入“错误传递步骤(conduit step)”概念——即本身未被判定为故障、却将上游错误忠实传播至下游的正确步骤,以保证错误传播链条的完整可追溯。归因阶段从终端故障节点沿依赖图反向追溯,仅将确认无故障祖先的候选步骤判定为根因,并结合故障严重度、影响范围与传播深度进行评分排序,最终生成含根因、传播链与修复优先级建议的结构化诊断报告。
Part.4 实验验证与成效
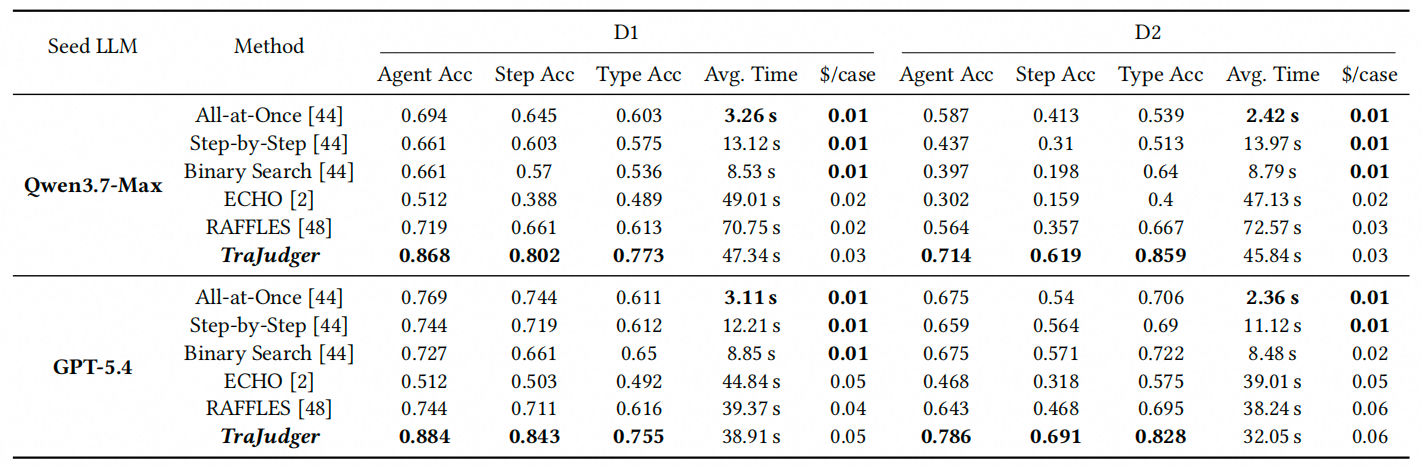
研究团队在两个数据集上对TraJudger进行了系统评估:D1为阿里巴巴121条生产故障轨迹,D2为Who&When基准数据集的126条故障轨迹。结果表明,在两种基座模型下,TraJudger在智能体级、步骤级与故障类型准确率上均全面超越三类主流基线(Who&When评判器、ECHO、RAFFLES),相对最优基线提升至少15%(智能体级)与13.3%(步骤级),在故障类型识别上提升幅度达10.5至19.2个百分点。
在计算开销方面,TraJudger可在一分钟以内完成单次诊断,单案例API成本低至0.03至0.06美元,兼顾准确性与工业部署的实用性。人工评估还表明,在正确定位根因的102个案例中,81.4%的错误传播链被工程师判定为准确刻画了故障传播路径。
Part.5研究意义与展望
本研究展示了结构化LLM推理框架在多智能体系统故障归因领域的强大潜力。TraJudger通过引入显式依赖结构重建、分类型专项检测与图约束反向追踪,不仅显著提升了故障归因的准确性与效率,更重要的是将根因推理锚定于可验证的结构证据之上,增强了诊断过程的可解释性与可操作性,为自动化运维方法在复杂工业多智能体场景的成功落地提供了宝贵实践范例。
未来,团队计划探索面向超长轨迹的处理策略以及支持多根因并发场景的归因评估,以期进一步提升系统的综合诊断能力。

 津南校区地址:天津市津南区海河教育园同砚路38号
 邮编:300350